创建计算资源
下载
聚焦模式
字号
本文介绍如何在工作空间中创建计算资源,并管理其全生命周期(启动、停止、编辑、删除)。
概述
DataBuddy 提供 4 种集群类型:作业集群、交互式集群、平台集群、实时集群,可在创建过程中按需选择。
前提条件
您已加入目标工作空间,并具备可创建计算资源 的角色权限。
您的账号具有腾讯云下单权限。
说明:
进入计算资源管理
在左侧导航栏选择 计算资源 ,进入资源列表页。列表展示当前工作空间内已创建的所有计算资源:
列 | 说明 |
资源名称 / ID | 名称由您创建时输入,ID 由系统自动生成;单击名称进入详情页 |
状态 | 集群状态生命周期 ,支持过滤 |
资源类型 | 作业集群、交互式集群、平台集群、实时集群,支持过滤 |
集群类型 | 底层引擎类型(Spark / Flink 等) |
资源上限 | 已配置的 CU 配额上限 |
计费方式 | 按量计费 |
无任务自动停止 | 仅交互式集群展示具体时间,其他集群展示 - |
创建人 | 计算资源的创建用户,支持过滤 |
操作 | 启动 / 停止 / 编辑 / 删除 / 充值 / 更多 |
支持以下列表操作:
搜索 :按资源名称 / ID 模糊搜索。
过滤 :按状态、资源类型、创建人过滤。
刷新 :手动刷新列表。
创建计算资源
1. 在资源列表页右上角单击 + 创建计算资源 。
2. 在“创建计算资源”弹窗中按以下两段配置:
基本信息
参数 | 说明 | 是否必填 | 默认值 |
资源名称 | 显示名称,支持中文、英文大小写字母、数字以及 -、_,长度不超过 50 个字符 | 是 | - |
资源描述 | 资源用途说明,便于团队识别 | 否 | 空 |
资源配置
参数 | 说明 | 是否必填 | 默认值 |
资源类型 | 选择 作业集群 / 交互式集群 / 平台集群 / 实时集群 ,每个选项卡片下方显示该类型的适用场景说明 | 是 | 作业集群 |
集群类型 | 支持 Spark 集群和 Ray 集群,仅 作业集群 显示 | 是 | Spark |
计算类型 | CPU,仅 作业集群 显示 | 是 | CPU |
镜像版本 | 集群底层引擎的镜像版本(如 Standard-S 1.1 / Spark 3.5);作业集群下可勾选 机器学习 切换至机器学习场景镜像 | 是 | Standard-S 1.1 |
资源配额 | 拖动滑块设置 CU 配额上限。范围 16 ~ 1024 CU,刻度标记 16 / 64 / 128 / 256 / 512 / 1024,步长 1。 1 CU ≈ 1 核 4 GB | 是 | 64 CU |
网络设置 | 选择需要打通的 VPC 与子网,仅 平台集群 与 实时集群 显示。 | 是(平台 / 实时集群) | 空 |
计费模式 | 按量计费 | 是 | 按量计费 |
配置费用 | 系统根据配额范围动态计算每小时的预估费用区间(按实际使用 CU 量计费) | 自动 | 自动 |
注意:
作业集群、交互式集群会产生 DLC 数据湖计算 的按量计费订单,请确保账号拥有对应的下单权限。
交互式集群专属配置
交互式集群额外提供 无任务自动停止 配置:
参数 | 说明 | 是否必填 | 默认值 |
单实例并发 | 单个计算资源支持多少个 SQL 同时运行,超出的任务会进行排队。 | 是 | 32 |
自动停止 | 开关。开启后,集群在无任务运行 N 分钟后自动停止;当有任务将要运行时自动启动。可设置 1 ~ 99999 分钟 | 是 | 开启,10 分钟 |
1. 完成所有配置后,单击底部按钮:
按钮 | 适用集群 | 行为 |
创建并启动 | 仅交互式集群 | 保存配置并实际拉起集群,集群状态变为“运行中” |
创建 | 全部 | 保存配置;交互式集群状态为“待启动”(不消耗资源),其他集群状态为“运行中” |
取消 | 全部 | 放弃配置 |
2. 保存成功会出现
${资源名称} 创建成功! 提示。启动 / 停止集群
启动 / 停止操作仅适用于 交互式集群 。其他集群类型的资源占用由任务本身控制,不需要手动启停。
启动 :在列表的操作列单击 启动 或在详情页右上角单击 启动 。
停止 :操作位置同上。
说明:
开启了“无任务自动停止”的交互式集群在闲时会自动停止;当有任务再次运行时会自动启动,无需手动管理。
编辑集群
1. 在列表操作列单击编辑 。
2. 编辑窗口中除 资源类型 外,其他配置都可以修改。
注意:
资源类型 字段在编辑状态下不可修改。如需更换类型,请删除后重建。
3. 单击 保存 后,集群状态为“变配中 ”,等待变配完成后自动恢复运行。
删除集群
操作流程:
1. 在列表操作列或详情页右上角单击 删除 。
2. 在确认窗口中输入资源名称(输入正确才能单击删除 ):
如果当前集群中有作业正在运行,需要勾选 强制删除 。强制删除会停止集群中所有作业。
如果不勾选强制删除,系统会先检测是否存在运行中的作业,存在时提示:该集群下有作业正在运行,如要继续删除请勾选强制删除。
3. 单击 删除 完成。
警告:
删除集群是不可恢复 的操作,且会立即停止所有运行中的任务。请在删除前确认:① 任务已迁移到其他集群;② 集群中的运行历史不再需要查询。
引用计算资源
集群创建并进入“运行中”状态后,您可以在以下入口选择该计算资源:
任务类型 | 入口 | 可选集群类型 |
Notebook 任务 / Python File 任务 / Ray 任务 / SQL 任务 | Workflow 任务配置面板 | 作业集群 |
离线数据接入任务 | 数据接入任务配置 | 平台集群 |
实时数据接入任务 | 数据接入任务配置 | 实时集群 |
SQL 探索 / Dashboard / ChatBI / 文件上传 | 任务编辑器顶部 | 交互式集群 |
计算资源下拉列表会显示资源名称和剩余 CU 数(如
集群 1 | 实时同步剩余 CU:2 / 16):括号内左侧是当前集群已使用的同类任务 CU 数,右侧是该集群的资源上限。使用限制
资源类型不可修改 :编辑状态下资源类型字段不可改,如需切换类型必须删除后重建。
强制删除会终止运行任务 :删除前请先迁移或停止运行中的任务。
CU 配额步长 :建议按 16 / 64 / 128 等常用刻度配置,以便排查负载问题。
常见问题
创建集群时提示权限问题如何处理?
请联系账号管理员在 CAM 控制台为当前账号添加下单相关策略。完成授权后回到 DataBuddy 重新创建。
编辑集群配额后多久生效?
变配过程通常在分钟级完成。变配期间集群状态显示“变配中”,期间无法接受新任务,已运行的任务不会被中断。建议在低峰时段操作。
“待启动”状态的交互式集群是否计费?
“待启动”状态下集群不实际占用计算资源,不产生 CU 用量费用 。只有进入“运行中”状态后才会按实际使用量计费。
子账号无法购买计算资源怎么办?
子账号无法购买 DataBuddy 的计算资源,原因是没有购买下单或创建对应集群的权限,您可以找到主账号 或拥有较高权限的子账号 (如:AdministratorAccess)持有者,参考如下方式对子账号进行授权。
方式一:通过预设策略授权
1. 选择子账号:进入 CAM 用户列表,找到要授权的子账号,单击授权 。
2. 授权预设策略:搜索预设策略名称“QcloudDataBuddyComputeBy”,即可完成授权。
说明:
由于 DataBuddy 交互式集群、作业集群需基于数据湖计算(DLC)引擎创建,因此授权预设策略后,子账号将可以购买 DataBuddy、数据湖计算(DLC)相关云产品。
方式二:通过自定义策略授权
1. 创建自定义策略:进入 CAM 策略页面,单击新建自定义策略 ,将如下 JSON 填入策略内容中,随后在基本信息页面自定义策略名词及描述,此时您也可以在该页面直接授权(可选)。
{"statement": [{"action": ["cam:PassRole"],"condition": {"string_equal": {"qcs:passed_to_service": ["wedata.cloud.tencent.com"]}},"effect": "allow","resource": ["*"]},{"action": ["finance:trade"],"effect": "allow","resource": ["qcs::dlc:::*","qcs::wedata:::*"]},{"action": ["dlc:CreateDataEngine"],"effect": "allow","resource": ["*"]}],"version": "2.0"}
2. 选择子账号:进入用户列表页,找到要授权的子账号,单击授权 。
3. 授权预设策略:搜索自定义策略名称,即可完成授权。
在创建完计算资源后,如何创建引擎?
某些计算资源在创建出来后,需进一步创建引擎才能使用,创建步骤如下:
步骤 | 操作 |
进入计算资源列表 | 如图,找到需创建引擎的计算资源,并点击“更多-引擎管理”: 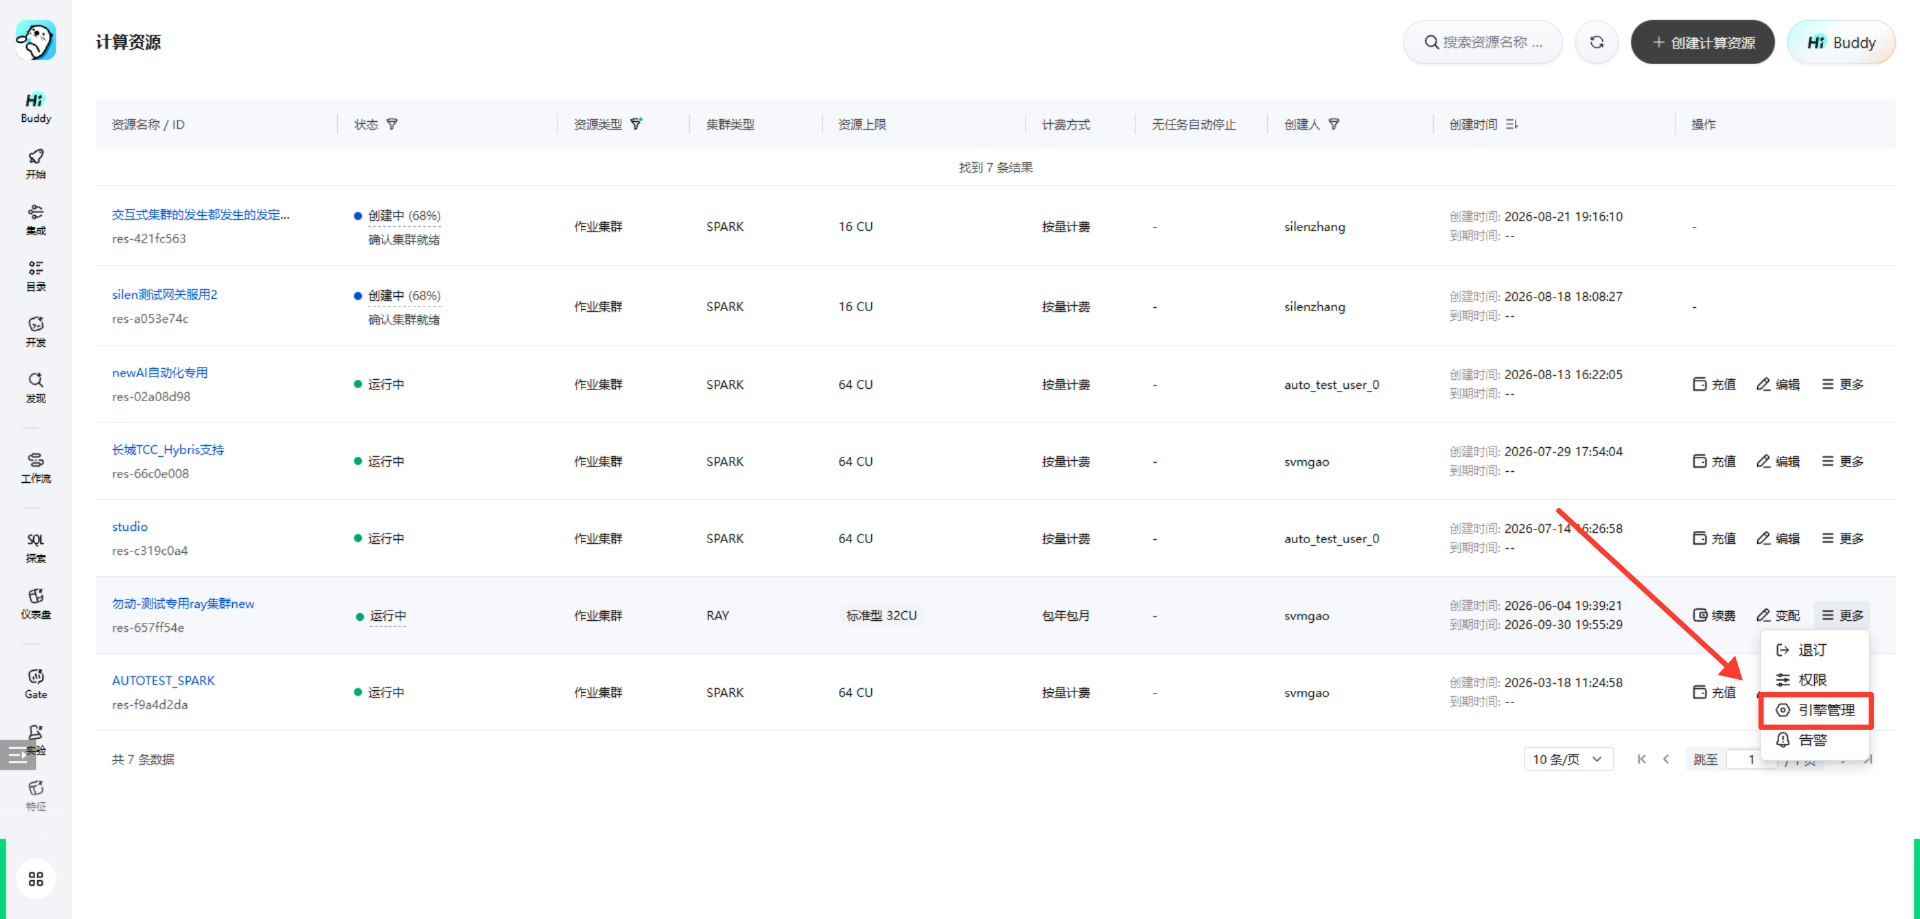 |
创建集群 | 如图: 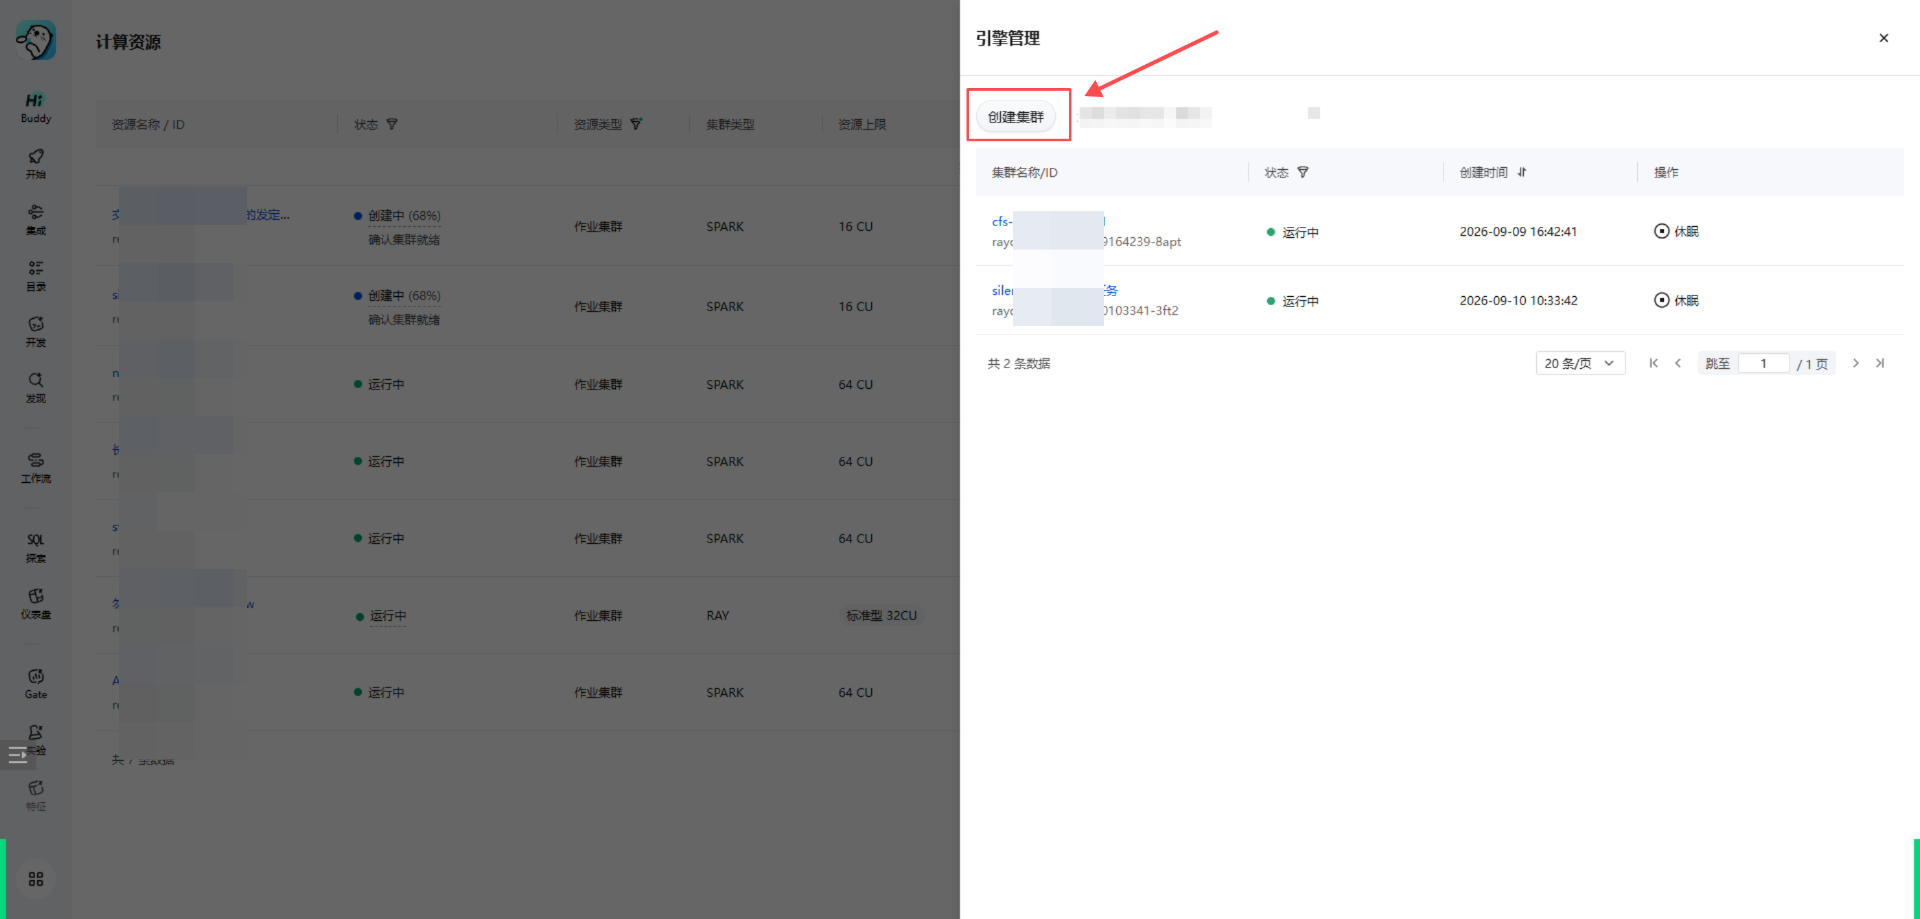 |
文档反馈