データ購読正規表現
ダウンロード
フォーカスモード
フォントサイズ
正規表現とは何ですか。
正規表現は、テキストから特定のパターンに一致するテキストを検索するために使用されるものです。
正規表現は左から右へ文字列をマッチングするものです。「Regular Expression」という言葉は長すぎるため、通常はその略語である「regex」または「regexp」を使用します。
正規表現は、文字列内のテキストの置換、フォームの検証、パターンマッチングに基づく文字列からの文字列抽出などに使用できます。
アプリケーションを作成していて、ユーザーがユーザー名を選択する際にルールを設定したい場合。ユーザー名には英字、数字、アンダースコア、ハイフンを含めることができます。
表示を美しくするために、ユーザー名の文字数を制限したい場合。以下の正規表現を使用してユーザー名を検証できます:
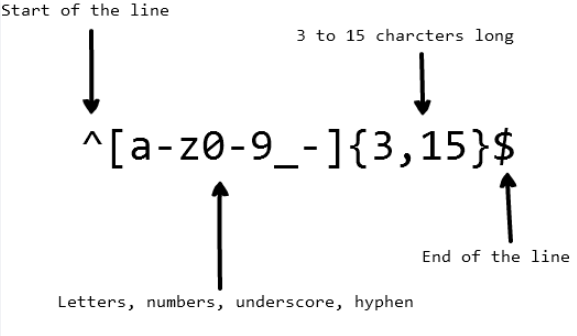
上記の正規表現は
john_doe、jo-hn\\_doe、john12\\_asにマッチできます。しかし、Joにはマッチできません。なぜなら、その文字列には大文字が含まれており、かつ短すぎるからです。目次
基本マッチ
正規表現は、テキスト内の文字と数字を検索するために使用するパターンにすぎません。例えば、正規表現
catは、文字cの後に文字aが続き、その後に文字tが続くことを意味します。"cat" => The cat sat on the mat
正規表現
123は文字列「123」にマッチします。正規表現内の各文字を、マッチ対象の文字列内の各文字と1つずつ比較することで、正規表現マッチングが行われます。
正規表現は通常、大文字と小文字を区別するため、正規表現Catは文字列「cat」にマッチしません。"Cat" => The cat sat on the Cat
メタ文字
メタ文字は正規表現の基本構成要素です。メタ文字はここでは通常の意味とは異なり、特殊な意味として解釈されます。一部のメタ文字は角括弧内に記述されると特殊な意味を持ちます。
メタ文字は以下の通りです:
メタ文字 | 説明 |
. | 改行文字以外の任意の文字にマッチします。 |
[ ] | 文字クラスは、角括弧内に含まれる任意の文字にマッチします。 |
[^ ] | 否定文字クラス。角括弧内に含まれない任意の文字に一致します。 |
* | 直前の部分式に0回以上一致します。 |
+ | 直前の部分式に1回以上一致します。 |
? | 前の部分式に0回または1回マッチするか、または非貪欲な量指定子を指定します。 |
{n,m} | 中括弧は、前の文字に少なくともn回、ただしm回を超えない範囲でマッチします。 |
(xyz) | 文字グループは、正確な順序で文字xyzにマッチします。 |
| | 分岐構造は、記号の前または後ろの文字にマッチします。 |
\ | エスケープ文字です。元の文字の意味を復元し、予約文字 [ ] ( ) { } . * + ? ^ $ \\ | に一致させることができます。 |
^ | 行の先頭に一致します。 |
$ | 行の末尾に一致します。 |
英文ピリオド
英文のピリオド
.は、メタ文字の最も簡単な例です。メタ文字.は任意の単一文字にマッチします。改行文字と新しい行の文字にはマッチしません。例えば、正規表現.arは、任意の文字の後に文字aが続き、その後に文字rが続くことを意味します。".ar" => The car parked in the garage.
文字セット
文字セットは文字クラスとも呼ばれます。角括弧は文字セットを指定するために使用されます。文字セット内のハイフンを使用して文字範囲を指定します。角括弧内の文字範囲の順序は重要ではありません。
例えば、正規表現
[Tt]heは、大文字Tまたは小文字tの後に文字hが続き、その後に文字eが続くことを意味します。"[Tt]he" => The car parked in the garage.
ただし、文字セット内の英文ピリオドは文字通りの意味を表します。正規表現
ar[.]は、小文字a、その後に文字r、さらにその後に英文ピリオド.文字が続くことを意味します。"ar[.]" => A garage is a good place to park a car.
否定文字セット
一般的に、挿入文字
^は文字列の開始を表しますが、角括弧内に現れると文字セットを打ち消します。例えば、正規表現[^c]arは、文字c以外の任意の文字、その後に文字a、さらにその後に文字rが続くことを意味します。"[^c]ar" => The car parked in the garage.
繰り返し
以下のメタ文字
+、*、または?は、サブパターンが出現できる回数を指定するために使用されます。これらのメタ文字は、状況によって異なる役割を果たします。アスタリスク
この記号
*は、直前のマッチルールの0回以上の繰り返しにマッチすることを示します。正規表現a*は、小文字aが0回以上繰り返されることを示します。ただし、これが文字セットまたは文字クラスの後に現れる場合、文字セット全体の繰り返しを示します。
例えば、正規表現[a-z]*は、1行に任意の数の小文字を含めることができることを示します。"[a-z]*" => The car parked in the garage.
この
*記号はメタ記号.と共に使用でき、任意の文字列.*にマッチします。この*記号はスペース文字\\sと共に使用でき、連続するスペース文字にマッチします。
例えば、正規表現\\s*cat\\s*は、0個以上のスペース、その後に小文字c、その後に小文字a、その後に小文字t、さらにその後に0個以上のスペースが続くことを示します。"\\s*cat\\s*" => The fat cat sat on the cat.
プラス記号
この記号
+は、直前の文字の1回以上の出現にマッチします。例えば、正規表現c.+tは、小文字c、その後に任意の数の文字、その後に小文字tが続くことを示します。"c.+t" => The fat cat sat on the mat.
疑問符
正規表現では、メタ文字
?は前の文字がオプションであることを示すために使用されます。この記号は前の文字の0回または1回の出現にマッチします。
例えば、正規表現[T]?heは、オプションの大文字T、その後に小文字h、その後に小文字eが続くことを示します。"[T]he" => The car is parked in the garage.
"[T]?he" => The car is parked in the garage.
中括弧
正規表現では、中括弧(量指定子?とも呼ばれます)は、文字または文字グループが繰り返される回数を指定するために使用されます。例えば、正規表現
[0-9]{2,3}は、少なくとも2桁、最大3桁の数字(0から9の範囲の文字)にマッチすることを示します。"[0-9]{2,3}" => The number was 9.9997 but we rounded it off to 10.0.
2番目の数字は省略できます。例えば、正規表現
[0-9]{2,}は、2個以上の数字にマッチすることを示します。カンマも削除した場合、正規表現[0-9]{2}は、ちょうど2桁の数字にマッチすることを示します。"[0-9]{2,}" => The number was 9.9997 but we rounded it off to 10.0.
"[0-9]{2}" => The number was 9.9997 but we rounded it off to 10.0.
文字クラス
文字グループは、丸括弧内に記述されたサブパターンの集合
(...)です。正規表現で説明したように、量指定子を文字の後に置くと、直前の文字を繰り返します。
しかし、量指定子を文字グループの後に置くと、文字グループ全体を繰り返します。
例えば、正規表現(ab)*は、文字列「ab」の0回以上の繰り返しにマッチすることを示します。また、文字グループ内でメタ文字|を使用することもできます。例えば、正規表現(c|g|p)arは、小文字c、g、またはpの後に文字a、その後に文字rが続くことを示します。"(c|g|p)ar" => The car is parked in the garage.
分岐構造
正規表現では、垂直バー
|は分岐構造を定義するために使用されます。分岐構造は、複数の式の間の条件のようなものです。ここで、この文字セットと分岐構造は同じように動作すると考えるかもしれません。しかし、文字セットと分岐構造の大きな違いは、文字セットは文字レベルでのみ機能し、分岐構造は式レベルでも使用できることです。
例えば、正規表現
(T|t)he|carは、大文字Tまたは小文字t、その後に小文字h、その後に小文字eまたは小文字c、その後に小文字a、その後に小文字rが続くことを示します。"(T|t)he|car" => The car is parked in the garage.
特殊文字のエスケープ
正規表現では、バックスラッシュ
\\を使用して次の文字をエスケープします。これにより、予約文字をマッチング文字として使用できます{ } [ ] / \\ + * . $ ^ | ?。特殊文字の前に\\を付けると、それをマッチング文字として使用できます。
例えば、正規表現.は改行文字以外の任意の文字にマッチするために使用されます。入力文字列内で.文字にマッチさせる場合、正規表現(f|c|m)at\\.?は、小文字f、c、またはmの後に小文字a、その後に小文字t、その後にオプションの.文字が続くことを示します。"(f|c|m)at\\.?" => The fat cat sat on the mat.
アンカー
正規表現では、マッチングシンボルが開始シンボルか終了シンボルかをチェックするために、アンカーを使用します。
アンカーには2種類あります:1つ目は
^で、マッチング文字が開始文字かどうかをチェックします。2つ目は$で、マッチング文字が入力文字列の最後の文字かどうかをチェックします。キャレット
挿入記号
^は、マッチング文字が入力文字列の最初の文字かどうかをチェックするために使用されます。正規表現^a(aが開始記号の場合)を使用して文字列abcにマッチングすると、aにマッチします。
しかし、正規表現^bを使用した場合、何もマッチしません。文字列abcでは「b」は開始文字ではないためです。
別の正規表現^(T|t)heを見てみましょう。これは、大文字Tまたは小文字tが入力文字列の開始記号であり、その後に小文字h、その後に小文字eが続くことを示します。"(T|t)he" => The car is parked in the garage.
"^(T|t)he" => The car is parked in the garage.
ドル記号
ドル記号
$は、マッチング文字が入力文字列の最後の文字かどうかをチェックするために使用されます。例えば、正規表現(at\\.)$は、小文字a、その後に小文字t、その後に.文字が続き、このマッチャーが文字列の末尾でなければならないことを示します。"(at\\.)" => The fat cat. sat. on the mat.
"(at\\.)$" => The fat cat sat on the mat.
省略文字セット
正規表現は、よく使われる文字セットとよく使われる正規表現に省略形を提供します。省略形の文字セットは以下の通りです:
略称 | 説明 |
. | 改行文字以外の任意の文字にマッチします。 |
\\w | すべての英数字にマッチする文字: [a-zA-Z0-9_] |
\\W | 英数字以外の文字にマッチします: [^\\w] |
\\d | 数字にマッチします: [0-9] |
\\D | 数字以外にマッチします: [^\\d] |
\\s | 空白文字にマッチします: [\\t\\n\\f\\r\\p{Z}] |
\\S | 非空白文字にマッチします: [^\\s] |
アサーション
後読みアサーションと先読みアサーションは、単にアサーションと呼ばれることもあります。これらは特殊なタイプの非キャプチャグループ(マッチングモードに使用されますが、マッチングリストには含まれません)です。特定のパターンの前または後にこのようなパターンがある場合、アサーションが優先的に使用されます。
例えば、入力文字列
$4.44 and $10.88から$文字より前のすべての数字を取得したいとします。この正規表現(?<=\\$)[0-9\\.]*を使用できます。これは、$文字より前のすべての数字(.文字を含む)を取得することを示します。
以下は正規表現で使用されるアサーションです:符号 | 説明 |
?= | 肯定先読みアサーション |
?! | 否定先読みアサーション |
?<= | 肯定後読みアサーション |
?<! | 否定後読みアサーション |
肯定的先読みアサーション
肯定先読みアサーションは、最初の部分の式が先読みアサーション式でなければならないと見なします。返されるマッチ結果には、最初の部分の式にマッチしたテキストのみが含まれます。
括弧内で肯定先読みアサーションを定義するには、括弧内で疑問符と等号を次のように使用します:
(?=...)。先読みアサーション式は括弧内の等号の後に記述します。
例えば、正規表現(T|t)he(?=\\sfat)は、大文字のTまたは小文字のtにマッチし、その後に文字h、さらに文字eが続くことを示します。
括弧内で肯定先読みアサーションを定義しており、これにより正規表現エンジンはTheまたはtheの後ろにfatが続く場合にマッチします。"(at\\.)$" => The fat cat sat on the mat.
否定的先読みアサーション
入力文字列から式にマッチしない内容を取得する必要がある場合、否定先読みアサーションを使用します。否定先読みアサーションの定義は、先ほど定義した肯定先読みアサーションと同じです。
唯一の違いは等号
=ではなく、否定記号!を使用することです。例えば(?!...)です。
次の正規表現(T|t)he(?!\\sfat)を見てみましょう。これは、入力文字列からすべてのTheまたはtheを取得し、かつfatの前にスペース文字がある場合にはマッチしないことを示します。"(T|t)he(?!\\sfat)" => The fat cat sat on the mat.
肯定的後読みアサーション
肯定後読みアサーションは、特定のパターンの前にあるすべてのマッチ内容を取得するために使用されます。肯定後読みアサーションは
(?<=...)と表されます。例えば、正規表現(?<=(T|t)he\\s)(fat|mat)は、入力文字列から単語Theまたはtheの後にあるすべてのfatおよびmat単語を取得することを示します。"(?<=(T|t)he\\s)(fat|mat)" => The fat cat sat on the mat.
否定的後読みアサーション
否定後読みアサーションは、特定のパターンの前にないすべてのマッチ内容を取得するために使用されます。否定後読みアサーションは
(?<!...)と表されます。例えば、正規表現(?<!(T|t)he\\s)(cat)は、入力文字列からTheまたはtheの後ろにないすべての単語catを取得することを示します。"(?<!(T|t)he\\s)(cat)" => The cat sat on cat.
マークアップ
マークは修飾子とも呼ばれます。これは正規表現の出力を変更するためです。これらのフラグは任意の順序または組み合わせで使用でき、正規表現の一部です。
マーキング | 説明 |
i | 大文字と小文字を区別しない:マッチングを大文字と小文字を区別しない設定にします。 |
g | グローバル検索:入力文字列全体からすべてのマッチを検索します。 |
m | 複数行マッチング:入力文字列の各行にマッチします。 |
大文字と小文字を区別しない
i修飾子は、大文字と小文字を区別しないマッチングを実行するために使用されます。例えば、正規表現/The/giは、大文字のT、その後に小文字のh、その後に文字eが続くことを示します。
しかし、正規表現のマッチング終了時にiフラグは正規表現エンジンにこの状況を無視するように指示します。ご覧のとおり、入力文字列全体からマッチを検索するため、gフラグも使用しています。"The" => The fat cat sat on the mat.
"/The/gi" => The fat cat sat on the mat.
グローバル検索
g修飾子は、グローバルマッチングを実行するために使用されます(すべてのマッチを検索し、最初のマッチが見つかった時点で停止しません)。
例えば、正規表現/.(at)/gは、改行文字を除く任意の文字、その後に小文字のa、その後に小文字のtが続くことを示します。
正規表現の末尾にgフラグを使用しているため、入力文字列全体から各マッチ項目を検索します。".(at)" => The fat cat sat on the mat.
"/.(at)/g" => The fat cat sat on the mat.
複数行マッチ
m修飾子は、複数行のマッチングを実行するために使用されます。前述の(^, $)で説明したように、アンカーを使用して、マッチする文字が入力文字列の先頭または末尾であるかをチェックします。しかし、各行でアンカーを使用したいため、m修飾子を使用します。
例えば、正規表現/at(.)?$/gmは、小文字のa、その後に小文字のtが続き、改行文字を除く任意の文字に0回または1回マッチすることを示します。さらに、mフラグにより、正規表現エンジンは文字列の各行の末尾にマッチします。"/.at(.)?$/" => The fatcat saton the mat.
"/.at(.)?$/gm" => The fatcat saton the mat.
よく使う正規表現
タイプ | 式 |
正整数 | ^-\\d+$ |
負の整数 | ^-\\d+$ |
電話番号 | ^+?[\\d\\s]{3,}$ |
電話コード | ^+?[\\d\\s]+(?[\\d\\s]{10,}$ |
整数 | ^-?\\d+$ |
ユーザー名 | ^[\\w\\d_.]{4,16}$ |
英数字文字 | ^[a-zA-Z0-9]*$ |
スペースを含む英数字文字 | ^[a-zA-Z0-9 ]*$ |
パスワード | ^(?=^.{6,}$)((?=.*[A-Za-z0-9])(?=.*[A-Z])(?=.*[a-z]))^.*$ |
電子メール | ^([a-zA-Z0-9._%-]+@[a-zA-Z0-9.-]+\\.[a-zA-Z]{2,4})*$ |
IPv4アドレス | ^((?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?))*$` |
小文字 | ^([a-z])*$ |
大文字 | ^([A-Z])*$ |
ユーザー名 | ^[\\w\\d_.]{4,16}$ |
URL | ^(((http|https|ftp):\\/\\/)?([[a-zA-Z0-9]\\-\\.])+(\\.)([[a-zA-Z0-9]]){2,4}([[a-zA-Z0-9]\\/+=%&_\\.~?\\-]*))*$ |
VISAクレジットカード番号 | ^(4[0-9]{12}(?:[0-9]{3})?)*$ |
日付 (MM/DD/YYYY) | ^(0?[1-9]|1[012])[- /.](0?[1-9]|[12][0-9]|3[01])[- /.](19|20)?[0-9]{2}$ |
日付 (YYYY/MM/DD) | ^(19|20)?[0-9]{2}[- /.](0?[1-9]|1[012])[- /.](0?[1-9]|[12][0-9]|3[01])$ |
Mastercardクレジットカード番号 | ^(5[1-5][0-9]{14})*$ |
フィードバック